Вопрос 3
Представление символьных и строковых данных. Принципы построения кодовых таблиц ASCII, КОИ-8, ISO8859-5, Windows-1251, UTF-8, UTF-16
Представление символьных и строковых данных
В вычислительных системах символы не могут храниться в графическом виде. Вместо этого используется кодирование: каждому символу ставится в соответствие уникальное число (код).
Строки в памяти представляют собой массивы (последовательности) байтов или машинных слов, где каждый элемент — код отдельного символа. Существует два основных способа хранения строк: с терминальным символом (Null-terminated, C-strings), когда в конце строки ставится специальный стоп-символ (обычно нулевой байт
\0), и с префиксом длины (Pascal-strings), когда перед самой строкой в памяти хранится число, указывающее количество символов в ней. В БЭВМ массив символов занимает по одному байту (максимально 2 символа в 16-битном слове).Исторические стандарты и однобайтовые кодировки
ASCII (American Standard Code for Information Interchange) Базовый 7-битный стандарт кодирования, описывающий 128 символов. Коды
0–31отведены под управляющие символы (перевод строки, табуляция, возврат каретки), которые предназначались для управления принтерами и телетайпами. Коды32–127— печатные символы: латинский алфавит, цифры и знаки препинания. Восьмой бит изначально использовался для контроля четности (проверки ошибок), но с развитием ЭВМ стал применяться для расширения таблицы до 256 символов.КОИ-8 (Код обмена информацией) Восьмибитная кодировка, созданная для кириллицы. Ее главная особенность — кириллические буквы расположены в верхней половине таблицы так, что отбрасывание 8-го бита дает фонетически эквивалентный латинский символ (А -> A, Б -> B, Ц -> C). Из-за этого текст оставался читаемым в виде транслита при передаче через 7-битный канал, однако буквы кириллицы расположены не в строгом алфавитном порядке.
ISO 8859-5 Попытка создать единый международный стандарт 8-битной кодировки для кириллицы (включая сербский, болгарский и македонский языки). Кириллица здесь расположена строго по алфавиту в верхней половине таблицы. Существенным недостатком стало отсутствие важных символов псевдографики и специфических типографских знаков, из-за чего стандарт почти не использовался в России.
Windows-1251 Стандартная 8-битная кодировка, созданная Microsoft для русскоязычных версий ОС Windows. Русские буквы расположены в строгом алфавитном порядке (кроме буквы «Ё»). В таблице присутствуют почти все нужные типографские знаки, однако полностью отсутствуют символы псевдографики (рамки), что раньше сильно затрудняло оформление интерфейсов в консоли.
Семейство Unicode
С глобализацией интернета 8-битных кодировок (максимум 256 символов) стало критически не хватать, так как они не позволяли смешивать в одном документе разные алфавиты. Решением стал стандарт Unicode — единое адресное пространство, где каждому символу в мире присвоен уникальный номер (Code Point).
Ссылка на оригинал
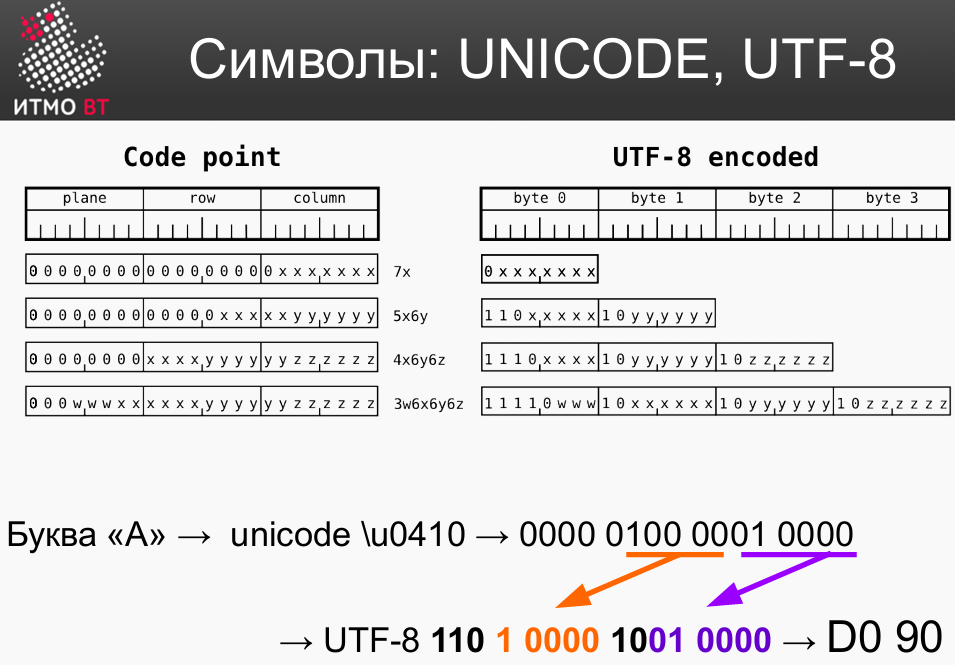
UTF-8 (Unicode Transformation Format - 8-bit) Самая популярная кодировка в интернете. Символы кодируются переменным числом байт (от 1 до 6, но на практике стандартизировано до 4). Коды от
U+0000доU+007Fзанимают 1 байт и побитово полностью совпадают с ASCII. Остальные символы (включая кириллицу) занимают от 2 до 4 байт. Старшие биты первого байта указывают длину последовательности (например,110xxxxx— 2 байта), а последующие байты всегда начинаются с префикса10xxxxxx. Это обеспечивает абсолютную обратную совместимость с ASCII-системами. Пример:
UTF-16 Символы кодируются последовательностями из 16-битных слов. Большинство базовых символов мировых алфавитов кодируются ровно в 2 байта. Редкие символы (например, исторические иероглифы, новые эмодзи) выходят за пределы 16 бит и кодируются “суррогатными парами” — двумя 16-битными словами (итого 4 байта). Формат требует обязательного учета порядка байтов (Big-Endian или Little-Endian).
Вопрос 25
Структура современных процессоров. Окружение процессора. CISC, RISC, VLIW
Структура современного процессора
Современный процессор (CPU) — это сложный многоядерный комплекс, включающий:
- Суперскалярность: способность процессора выполнять несколько инструкций параллельно за один такт.
- Кэш-память: иерархическая структура сверхбыстрой памяти (L1, L2 для каждого ядра и общая L3).
- Множество ядер: от 1 до 16 и более физических ядер на одном кристалле.
- Высокие тактовые частоты: от 500 МГц до 5 ГГц.
Архитектуры наборов команд
Философия проектирования процессоров исторически разделилась на три направления. Главное отличие между ними — баланс между сложностью “железа” (процессора) и сложностью компилятора.
CISC (Complex Instruction Set Computer)
Философия: «Сложный процессор, простой компилятор».
Команды имеют разную длину. Одна сложная команда может напрямую обращаться к ОЗУ, производить вычисления и сразу сохранять результат обратно.
- Плюсы: Программы занимают мало места в памяти (высокая плотность кода). Компилятору легко переводить языки высокого уровня в машинный код.
- Минусы: Процессору очень тяжело и долго расшифровывать (дешифровать) команды разной длины. “Железо” получается сложным, требует много транзисторов для логики управления.
RISC (Reduced Instruction Set Computer)
Философия: «Простой процессор, сложный компилятор». Набор команд сильно сокращён, все они имеют строго одинаковую длину. АЛУ работает только с регистрами, а для работы с ОЗУ есть только команды чтения и записи.
- Плюсы: Дешифратор процессора максимально прост, поэтому каждая команда выполняется молниеносно (строго за 1 такт). Аппаратная часть дешевле и энергоэффективнее.
- Минусы: Чтобы сделать сложное действие, нужно выполнить 4-5 простых команд, из-за чего код программы “раздувается”. Процессору требуется огромное количество регистров для хранения промежуточных данных.
VLIW (Very Long Instruction Word)
Философия: «Параллелизм на плечах компилятора». Архитектура призвана значительно увеличить скорость выполнения программ процессором за счет распараллеливания. Компилятор сам анализирует код программы, находит независимые друг от друга операции и упаковывает их в одну «сверхдлинную» машинную команду (пакет).
Ссылка на оригинал
- Плюсы: Высокая скорость выполнения программы, так как процессор аппаратно выполняет все инструкции из готового пакета одновременно на разных исполнительных блоках. Само “железо” процессора освобождается от сложной логики анализа зависимостей на лету.
- Минусы: Полная зависимость от качества компилятора. Если компилятор не сможет найти в коде достаточное количество независимых команд, часть исполнительных блоков процессора будет простаивать впустую.