Организация обмена по прерыванию программы в БЭВМ. Пример программы. Цикл прерывания
Принцип организации обмена по прерыванию
Аппаратные прерывания в БЭВМ позволяют процессору не тратить время на ожидание готовности внешних устройств (ВУ), а выполнять полезную работу. Инициатором обмена выступает само ВУ: при готовности оно посылает сигнал по линии запроса прерывания (IntRq).
Процессор проверяет наличие запросов в конце выполнения каждой инструкции в специальном цикле прерывания. Обмен возможен только при наличии флага разрешения прерываний EI (в регистре состояния PS) и включённого тумблера «Работа» (PS(W) = 1).
Цикл прерывания
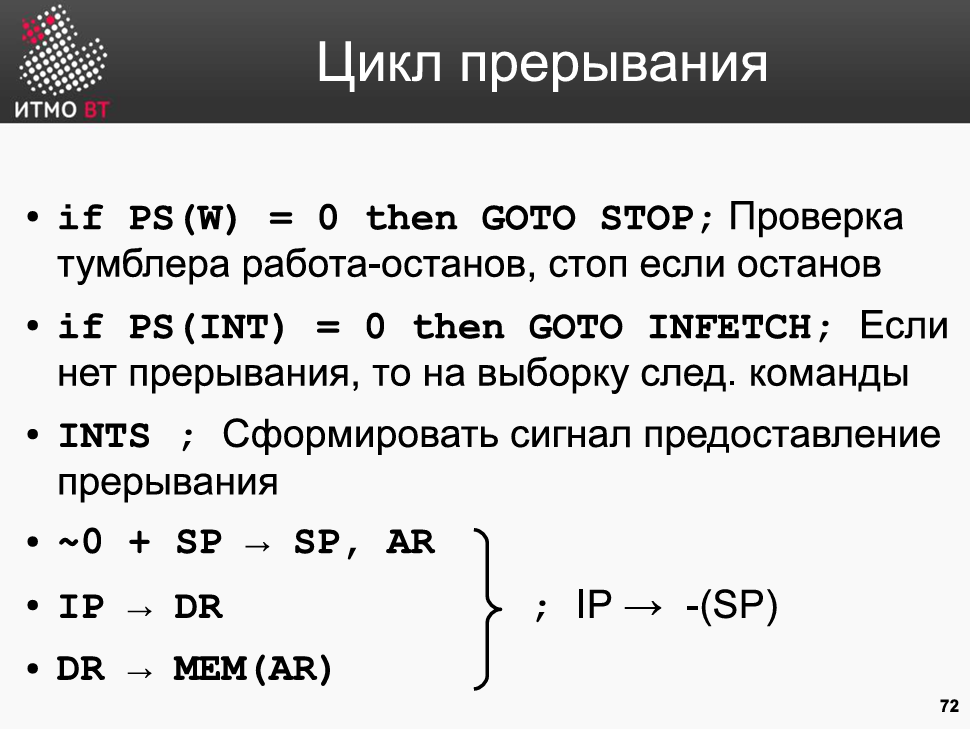
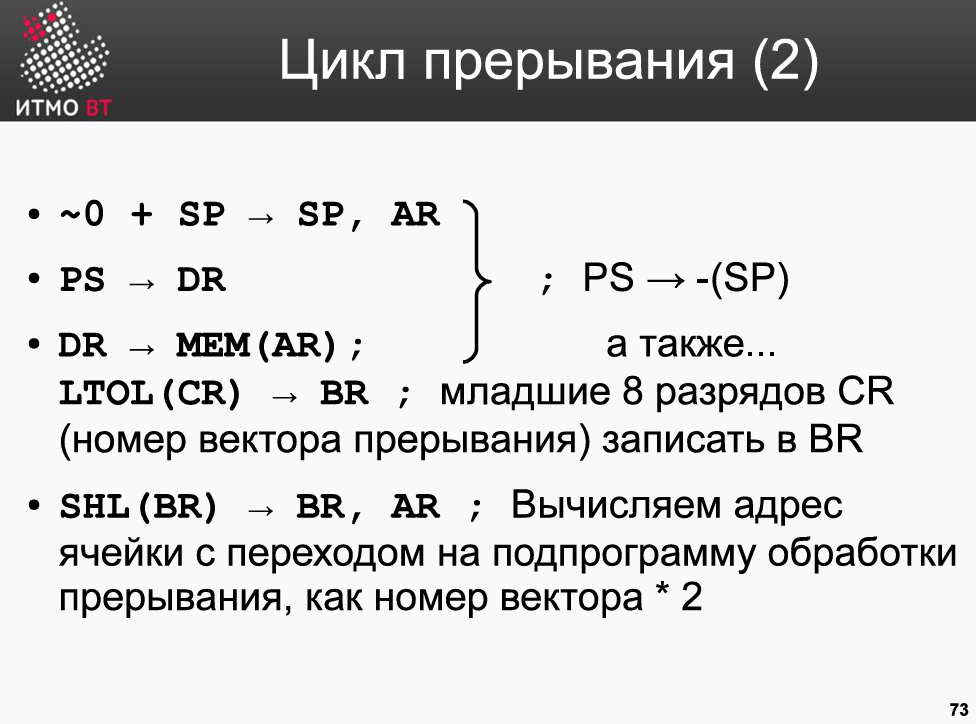
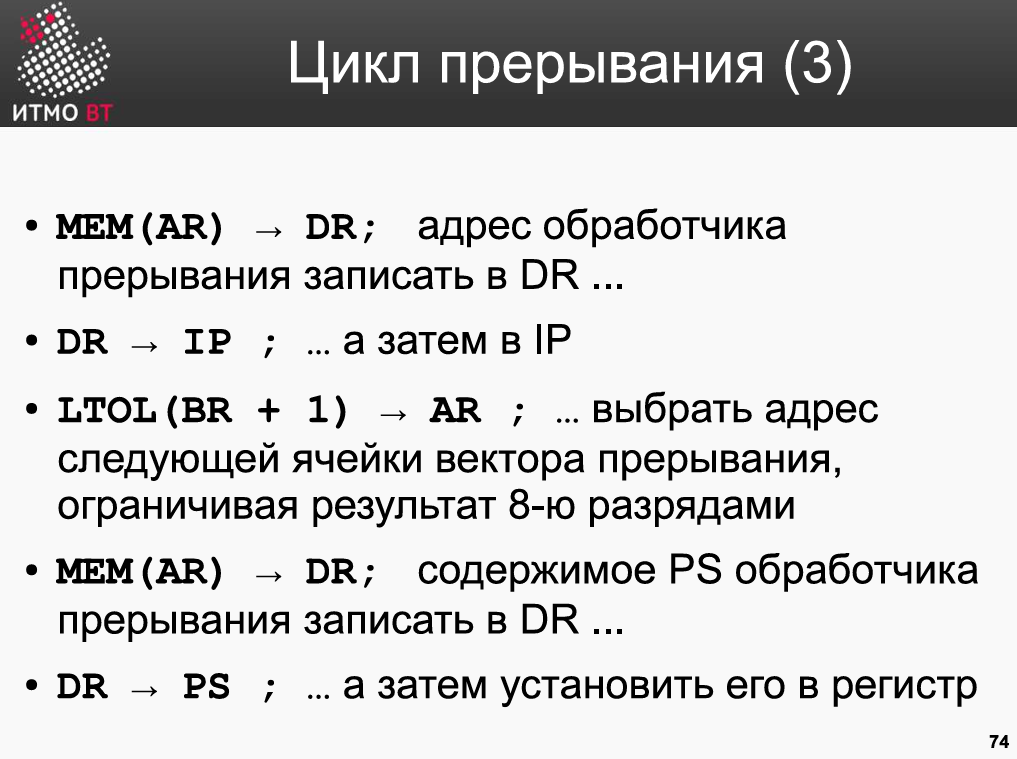
Цикл прерывания в БЭВМ выполняется аппаратно на уровне микропрограммного устройства управления. Он состоит из следующих микроопераций:
Проверка условий и IP→-(SP)
INTS - это микрокоманда, который заставляет процессор выставить сигнал предоставления прерывания и перебрать все прерывания по приоритету
PS→-(SP) и вычисление адреса ячейки, в которой начало программы обработки прерывания
Загрузка нового состояния процессора
Пример программы настройки и обработки прерывания
Программа настраивает ВУ-3 (текстовый принтер) на прерывание по вектору №3. Сам обработчик просто записывает символ в память по запросу.
ORG 0x0V3: WORD $INT3, 0x180ORG 0x20START: DI LD #0x0B ; 0x0B=0b1011.; Бит 3 - разрешаем прерывания, биты 0-2 - вектор 3 OUT 7 ; Запись в ВУ-3 (MR) EILOOP: INC BR LOOP; --- Обработчик прерывания ---ORG 0x40INT3: PUSH ; Сохранение AC в стек IN 6 ; Ввод из ВУ-3 в AC ST MEM_CELL ; Сохранение в память POP ; Восстановление аккумулятора IRET ; Возврат из прерыванияMEM_CELL: WORD 0
Архитектура многопроцессорных ЭВМ. Системный коммутатор. Архитектуры UMA и NUMA
Проблема системной шины и Системный коммутатор
При использовании единой общей системной шины в многопроцессорных системах возникает конфликт: когда один процессор работает с памятью, остальные вынуждены простаивать, ожидая освобождения шины.
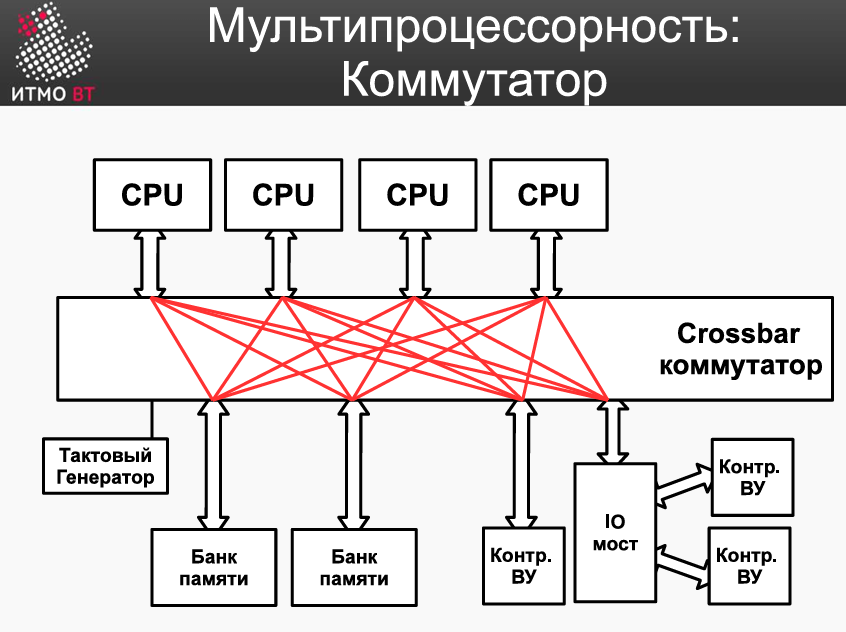
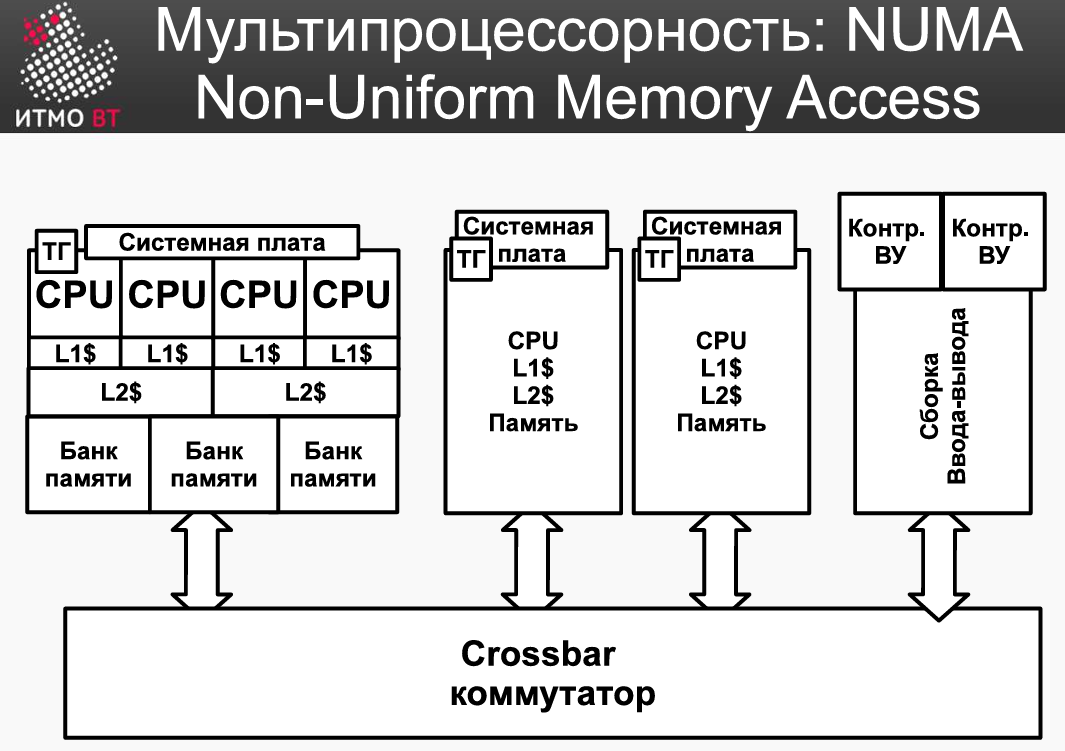
Решением проблемы ожидания является Crossbar коммутатор — полносвязная матрица соединений, где каждый связан с каждым. Она позволяет нескольким процессорам параллельно и бесконфликтно обращаться к разным независимым банкам памяти, убирая простои системы.
Архитектура UMA (Uniform Memory Access)
Архитектура с однородным доступом к памяти:
Принцип: Все процессоры делят между собой общий централизованный пул оперативной памяти.
Особенность: Время доступа к любой ячейке ОЗУ одинаково для любого процессора, независимо от того, какое ядро запрашивает данные.
При добавлении большого количества ядер коммутатор перегружается запросами, и общая производительность падает, так что UMA используется только для систем с небольшим числом процессоров
Архитектура NUMA (Non-Uniform Memory Access)
Архитектура с неоднородным доступом к памяти:
Принцип: Физически оперативная память разделена на локальные блоки, каждый из которых привязан к своему процессору. Все узлы объединены Crossbar коммутатором в единое адресное пространство.
Особенность: Время доступа к памяти неоднородно, зато работа процессоров со “своей” памяти происходит очень быстро. Ну и логично, что обращение к памяти другого узла через коммутатор требует больше времени.
Операционная система должна поддерживать NUMA-архитектуру, стараясь выделять процессу память строго на его локальном узле.